Was diese Seite erklärt
Thema anklicken, Abschnitt lesenVier Schritte von der Frage bis zur Antwort mit Quellenangabe.
Vier StellschraubenChunking, hybride Suche, Reranking und Kontextfenster.
RAG, Feintuning oder ChatGPTWelches Verfahren wann das richtige ist.
Bei billerbeck KIEigene Vektordatenbank, mitgeltende Leserechte, belegte Antworten.
Was RAG nicht kannWo das Verfahren an seine Grenzen stößt.
Häufige FragenAufwand, Datenschutz und die Qualität der Antworten.
RAG steht für Retrieval-Augmented Generation, auf Deutsch etwa: Antworten, die durch eine Suche gestützt werden. Statt aus dem Gedächtnis des Sprachmodells zu antworten, sucht das System zuerst die passenden Stellen in Ihren eigenen Dokumenten und formuliert die Antwort erst daraus. Deshalb steht unter jeder Antwort, aus welchem Dokument sie stammt.
Vier Schritte
von der Frage zur Antwort.
Eine Stichwortsuche scheitert, sobald Frage und Dokument verschiedene Wörter benutzen: Wer nach „Wie lange kann ich das Gerät zurückgeben?“ fragt, findet nichts, wenn im Vertrag „Widerrufsfrist“ steht. RAG sucht deshalb nach Bedeutung, nicht nach Zeichenfolgen.
Die Frage wird umgerechnet
Ein Embedding-Modell wandelt die Frage in eine Zahlenreihe um, die ihre Bedeutung abbildet. „Rechnung“ und „Faktura“ landen dabei dicht beieinander, obwohl kein Buchstabe übereinstimmt.
Die Vektordatenbank sucht
Ihre Dokumente liegen dort in Abschnitten, jeder mit derselben Art Zahlenreihe versehen. Gesucht wird, was der Frage inhaltlich am nächsten kommt.
Die Rechte werden geprüft
Die Leserechte des Originaldokuments gelten mit. Wer eine Datei nicht öffnen darf, bekommt sie auch nicht als Quelle vorgelegt und erfährt nicht, dass es sie gibt.
Das Modell formuliert
Erst jetzt kommt das Sprachmodell ins Spiel. Es bekommt die gefundenen Stellen vorgelegt und schreibt daraus die Antwort, mit Verweis auf die Dokumente, aus denen sie stammt.
Die Vektordatenbank verweist nur auf die passenden Passagen, Ihre Dokumente bleiben liegen, wo sie liegen, und bleiben maßgeblich. Neue und geänderte Dateien zieht das System im Hintergrund nach, einen Suchindex muss dafür niemand pflegen.
Vier Stellschrauben
entscheiden über die Qualität.
RAG ist schnell aufgesetzt und schwer gut hinzubekommen. Wer schon einmal eins gebaut hat, weiß, dass der Unterschied zwischen brauchbaren und unbrauchbaren Antworten fast immer an denselben vier Stellen liegt.
Ein Vertrag wandert nicht am Stück in die Vektordatenbank, sondern in Abschnitten. Wie groß die sind, entscheidet mit darüber, ob eine Antwort später Hand und Fuß hat. Zu kleine Abschnitte reißen Sätze auseinander, zu große schleppen so viel Beiwerk mit, dass die eigentliche Aussage untergeht.
Als pragmatischer Ausgangswert gelten in der Praxis 512 bis 1024 Token je Abschnitt, mit etwas Überlappung an den Rändern. Verfahren, die nach Bedeutung statt nach Zeichenzahl trennen, schneiden besser ab, kosten aber mehr Rechenzeit beim Einlesen.
Die Suche über Bedeutung hat eine bekannte Schwäche: Bei Artikelnummern, Aktenzeichen und Eigennamen ist sie der guten alten Stichwortsuche unterlegen. „Vertrag 2024-118″ findet ein Embedding-Modell schlechter als ein Volltextindex.
Deshalb laufen in ausgereiften Systemen beide Suchen parallel, und die Trefferlisten werden verrechnet. In veröffentlichten Messungen bringt das rund zehn Prozentpunkte bessere Trefferqualität gegenüber rein semantischer Suche.
Die Vektorsuche liefert schnell viele halbwegs passende Stellen. Ein zweites, genaueres Modell sieht sich diese Liste noch einmal an und sortiert sie um, bevor das Sprachmodell sie zu Gesicht bekommt.
Die übliche Faustregel: zwanzig Stellen suchen, auf fünf eindampfen, drei bis fünf ans Modell geben. Das kostet einen Moment mehr, verbessert die Antwortqualität aber deutlicher als fast jede andere Maßnahme.
Moderne Sprachmodelle könnten ganze Aktenordner auf einmal lesen. Trotzdem ist mehr nicht automatisch besser: Je mehr Beiwerk mitgeliefert wird, desto eher übersieht ein Modell die entscheidende Zeile.
Wenige, gut ausgewählte Stellen schlagen in der Regel viele mittelmäßige. Das ist auch der Grund, warum sich RAG nicht dadurch erledigt hat, dass Kontextfenster größer werden.
Diese Werte stammen aus der Fachliteratur, nicht aus unseren eigenen Messungen. Wie wir es im Einzelnen eingestellt haben, besprechen wir gern am konkreten Fall, weil die richtige Antwort von Ihren Dokumenten abhängt: Ein Bestand aus zweiseitigen Rechnungen verlangt andere Einstellungen als einer aus hundertseitigen Verträgen.
RAG, Feintuning
oder einfach ChatGPT fragen?
Drei Wege, einem Sprachmodell Firmenwissen beizubringen. Sie schließen sich nicht aus, lösen aber verschiedene Probleme.
| Worum es geht | Sprachmodell allein | Feintuning | RAG |
|---|---|---|---|
| Woher das Wissen kommt | Aus dem Training, Stand des Modells | Aus dem Training plus nachtrainierten Beispielen | Aus Ihren Dokumenten, zum Zeitpunkt der Frage |
| Aktualität | Veraltet ab dem Trainingsende | Veraltet ab dem Nachtraining | So aktuell wie das Dokument von heute Morgen |
| Nachvollziehbarkeit | Keine Quelle, die Antwort steht für sich | Keine Quelle, das Wissen steckt im Modell | Jede Antwort nennt das Dokument, aus dem sie stammt |
| Leserechte | Nicht anwendbar | Nicht trennbar: was eintrainiert ist, gilt für alle | Die Rechte des Originals gelten bei jeder Anfrage mit |
| Änderung eines Dokuments | Wirkt nicht | Erfordert erneutes Training | Wirkt beim nächsten Durchlauf, ohne Zutun |
| Was es gut kann | Allgemeinwissen, Formulieren, Übersetzen | Tonfall, Format, wiederkehrende Aufgabenmuster | Auskunft aus dem eigenen Bestand |
| Was es nicht kann | Ihre Verträge kennen | Sagen, woher eine Aussage stammt | Wissen, was nirgends aufgeschrieben ist |
In der Praxis läuft es meist auf RAG hinaus, gelegentlich ergänzt um Feintuning für den Tonfall. Wer sein Firmenwissen in ein Modell trainieren lässt, zahlt bei jeder Änderung erneut und verliert die Quellenangabe.
Was billerbeck KI
daraus macht.
RAG ist ein Verfahren, keine Software. Wie es umgesetzt ist, entscheidet, ob am Ende brauchbare Antworten herauskommen.
Eine eigene Vektordatenbank, die bei Ihnen läuft
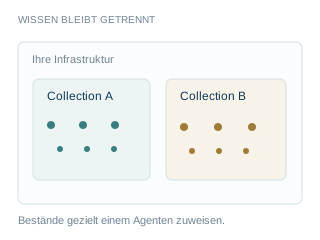
Wir setzen keinen fremden Suchdienst davor, sondern haben die Vektordatenbank selbst gebaut. Sie läuft auf Ihrer Infrastruktur mit, wahlweise on-premise oder in einem deutschen Rechenzentrum. Ihre Dokumentinhalte verlassen diesen Rahmen nicht, auch nicht als Zahlenreihe.
- Vector Collections trennen Bestände voneinander, statt alles in einen Topf zu werfen
- Die Wissensbasis eines Agenten wird gezielt zugewiesen, nicht pauschal geöffnet
- Neue und geänderte Dokumente ziehen laufend nach
Jeder Agent wird einzeln definiert
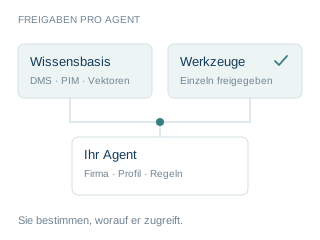
Im Agent Designer legen Sie fest, womit ein Agent arbeitet und was er darf. Dazu gehören die Zuordnung zu Firma und Autorenprofil, die Anweisungen an das Modell, die Wissensbasis und die Werkzeuge, auf die er zugreifen kann.
- Verknüpfungen zu DMS, PIM und der Vektordatenbank, einzeln freigegeben
- MCP-Anbindungen für Werkzeuge außerhalb der Plattform
- Regeln dafür, wie und wann das Modell ein Werkzeug benutzen darf
- Agenten können für Teilaufgaben eigene Unteragenten anlegen
Mehrere Agenten in einem Ablauf
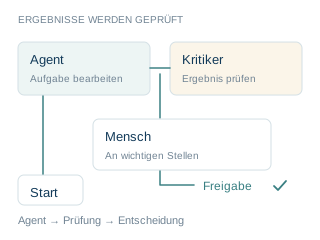
Im Workflow-Werkzeug durchlaufen mehrere Agenten gemeinsam einen Prozess. Neben den ausführenden Agenten gibt es Kritiker, deren Aufgabe es ist, das Ergebnis der anderen zu prüfen, bevor es weitergereicht wird. An den Stellen, an denen es zählt, entscheidet trotzdem ein Mensch.
Das Modell ist austauschbar
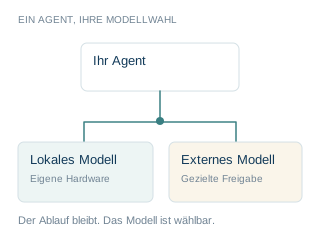
Pro Agent legen Sie fest, wo gerechnet wird. Lokale Modelle laufen auf Ihrer eigenen Hardware, ohne Verbindung nach außen. Wo es sinnvoll ist, lässt sich stattdessen ein externes Modell wie GPT oder Claude zuschalten. Dorthin geht dann nur, was Sie für diesen Agenten ausdrücklich freigegeben haben. Die Entscheidung lässt sich später ändern, ohne den Ablauf neu zu bauen.
Was RAG nicht
leisten kann.
Damit im Erstgespräch niemand etwas erwartet, was das Verfahren nicht hergibt.
Was nirgends steht, kann es nicht beantworten
RAG liest Ihre Dokumente, es weiß nichts darüber hinaus. Wissen, das nur in Köpfen steckt oder in einer Besprechung gefallen ist, bleibt unsichtbar. Das ist keine Schwäche der Software, sondern der Grund, warum die Datenbasis vor der KI kommt.
Widersprüchliche Dokumente ergeben widersprüchliche Antworten
Liegen drei Fassungen einer Preisliste im Bestand, findet das System sie alle. Welche davon gilt, klärt die KI nicht. Das entscheidet Ihre Ablage, über Versionen, Gültigkeitsdaten und das Aussortieren alter Stände.
Es findet Stellen, es rechnet nicht
„Welche Verträge laufen im nächsten Quartal aus?“ ist keine Suchfrage, sondern eine Auswertung über den ganzen Bestand. Dafür braucht es strukturierte Daten aus DMS oder PIM, nicht die Volltextsuche. In einem Workflow lassen sich beide Wege verbinden.
Schlecht erfasste Dokumente bleiben schwierig
Ein Scan ohne Texterkennung, eine Tabelle als Bild, ein Formular ohne Struktur: Was sich nicht als Text auslesen lässt, findet die Suche auch nicht. Die Erfassung im DMS entscheidet mit darüber, was die KI später beantworten kann.
RAG:
die wichtigsten Antworten.
In vier Schritten. Ein Embedding-Modell rechnet die Frage in eine Zahlenreihe um, die ihre Bedeutung abbildet, und die Vektordatenbank sucht darin die inhaltlich nächsten Textabschnitte. Dann werden die Leserechte der gefundenen Dokumente geprüft. Erst danach formuliert das Sprachmodell die Antwort und nennt dazu die Quelle.
Beim Feintuning wandert das Wissen fest ins Modell. Jede Änderung kostet ein neues Training, die Antwort nennt keine Quelle, und Leserechte lassen sich hinterher nicht mehr trennen. RAG dagegen sucht bei jeder Frage neu in den Dokumenten, wie sie gerade sind. Ändert jemand einen Vertrag, stimmt schon die nächste Antwort.
Nein. Die Vektordatenbank ist unsere eigene und läuft auf Ihrer Infrastruktur mit, on-premise oder gehostet in Deutschland. Setzen Sie lokale Sprachmodelle ein, verlässt überhaupt nichts Ihr Haus. Schalten Sie für einen Agenten ein externes Modell zu, geht dorthin nur, was Sie für diesen Agenten freigegeben haben.
Nein. Die Leserechte des Originaldokuments gelten bei jeder Anfrage mit. Wer eine Datei nicht öffnen darf, bekommt sie auch nicht als Quelle vorgelegt und erfährt nicht, dass es sie gibt. Zusätzlich lässt sich pro Agent festlegen, welche Wissensbasis er überhaupt benutzen darf.
Der erste Durchlauf über einen bestehenden Bestand läuft je nach Menge über Stunden bis wenige Tage, und zwar im Hintergrund. Danach zieht das System neue und geänderte Dokumente laufend nach. Einen Stichtag, zu dem alles fertig sein muss, gibt es nicht.
Dann sagt das System das. Ein Sprachmodell ohne Datengrundlage füllt solche Lücken mit etwas Plausiblem auf, hier bleibt die Antwort bei dem, was tatsächlich gefunden wurde. Über die Quellenangabe lässt sich das nachprüfen.
Wie RAG im Zusammenspiel mit Agenten und Workflows arbeitet, steht auf der Seite zu billerbeck KI. Einen Praxisbericht aus dem eigenen Haus gibt es unter Wie aus Ihrem Firmenwissen ein Assistent wird.
Würde das bei Ihren Unterlagen funktionieren?
Zeigen Sie uns einen Dokumententyp, in dem bei Ihnen regelmäßig gesucht wird. Wir sagen Ihnen, ob RAG damit zurechtkommt und was vorher an der Ablage zu tun wäre.
